สงครามราคา AI เดือด DeepSeek ทำต้นทุนถูกลง จนยักษ์ใหญ่ต้องขยับตาม

ลองนึกภาพว่าระบบหนึ่งต้องอ่านข้อมูลระดับหลายพันล้านโทเคน แต่บิลกลับอยู่แค่หลักสิบดอลลาร์ ภาพแบบนี้เมื่อไม่นานก่อนยังฟังคล้ายเรื่องเกินจริง เพราะต้นทุนของโมเดลภาษาไม่ได้มาจากแค่การสร้างคำตอบ แต่มาจากการต้องแบกบริบทจำนวนมหาศาลไว้ตลอดเวลาที่ประมวลผล
ประเด็นที่ทำให้ DeepSeek V4 Flash ถูกจับตาคือการพยายามแก้คอขวดตรงนี้โดยตรง รุ่นดังกล่าวเป็นโมเดลแบบ Mixture of Experts มีพารามิเตอร์รวม 284 พันล้านตัว แต่เปิดใช้งานประมาณ 13 พันล้านตัวต่อโทเคน และรองรับบริบทยาวถึง 1 ล้านโทเคน แนวคิดคือไม่จำเป็นต้องปลุกสมองทั้งก้อนขึ้นมาทำงานทุกครั้ง ถ้าเลือกเฉพาะส่วนที่เกี่ยวข้องได้ ต้นทุนต่อคำก็ลดลงทันที
เรื่องที่หนักกว่านั้นคือกลไก Attention ปกติ ยิ่งบริบทยาวก็ยิ่งกินทั้งกำลังคำนวณและหน่วยความจำ โดยเฉพาะ KV cache ที่ต้องเก็บข้อมูลจากข้อความก่อนหน้าไว้เพื่อสร้างคำถัดไป พอขยายไปถึงหลักแสนหรือหลักล้านโทเคน เซิร์ฟเวอร์ราคาแพงก็รับงานพร้อมกันได้น้อยลง ต้นทุนต่อผู้ใช้จึงสูงขึ้นตาม
DeepSeek เลือกใช้แนวทางที่ไม่บังคับให้โมเดลจ้องทุกโทเคนเท่ากันทั้งหมด สถาปัตยกรรม V4 ใช้การบีบอัดข้อมูลร่วมกับ sparse attention เพื่อให้ระบบมองภาพรวมของบริบทก่อน แล้วค่อยทุ่มการคำนวณละเอียดให้ส่วนที่น่าจะเกี่ยวข้องจริง วิธีนี้มีญาติทางความคิดกับงาน Native Sparse Attention ที่เสนอการบีบอัด การเลือกส่วนสำคัญ และการเก็บบริบทใกล้ปัจจุบันไว้พร้อมกัน แทนที่จะลากทุกคำในอดีตมาคำนวณแบบเต็มรูปทุกครั้ง
ตัวเลขจาก DeepSeek ระบุว่าในบริบทขนาด 1 ล้านโทเคน รุ่น V4 Pro ใช้ FLOPs สำหรับการอนุมานต่อหนึ่งโทเคนประมาณ 27% และใช้ KV cache ราว 10% เมื่อเทียบกับ V3.2 นี่ไม่ได้แปลว่าเร็วขึ้นหรือถูกลงในทุกงานแบบเส้นตรง แต่แสดงชัดว่าการออกแบบโมเดลเริ่มแข่งขันกันที่ประสิทธิภาพของระบบ ไม่ใช่ไล่เพิ่มจำนวนพารามิเตอร์อย่างเดียว
จุดที่ทำให้เรื่องนี้ลามไปเป็นสงครามราคาคือต้นทุนบริการ API ปัจจุบันของ DeepSeek V4 Flash สำหรับข้อมูลขาเข้าที่ไม่โดนแคชอยู่ที่ 0.14 ดอลลาร์ต่อหนึ่งล้านโทเคน และถ้าเป็นข้อมูลที่แคชไว้แล้วจะถูกกว่านั้นมาก ตัวเลขระดับนี้ทำให้งานที่เคยต้องคอยตัดข้อความ ทิ้งประวัติ หรือย่อเอกสารเพื่อประหยัดเงิน เริ่มมีทางเลือกใหม่ เช่น ป้อนฐานโค้ดขนาดใหญ่ เอกสารจำนวนมาก หรือประวัติการทำงานของเอเจนต์เข้าไปทีเดียวแล้วปล่อยให้ระบบค้นหาส่วนที่เกี่ยวข้องเอง
วันที่ 30 กรกฎาคม 2026 OpenAI ประกาศลดราคา GPT-5.6 Luna ลง 80% และ Terra ลง 20% พร้อมอธิบายว่าประสิทธิภาพของระบบดีขึ้นจนสามารถส่งต่อการประหยัดต้นทุนให้ลูกค้าได้ จังหวะเวลานี้เกิดท่ามกลางการแข่งขันจากโมเดลจีนราคาต่ำหลายค่าย จึงทำให้ตลาดตีความว่าแรงกดดันด้านราคากำลังบีบผู้เล่นรายใหญ่ให้ขยับเร็วขึ้น แต่ยังไม่มีหลักฐานจาก OpenAI ที่ยืนยันตรงๆ ว่าการลดราคาครั้งนี้เกิดเพราะ DeepSeek เพียงรายเดียว
ตรงนี้ควรแยกข่าวพาดหัวออกจากข้อเท็จจริงให้ชัด เพราะคำว่า DeepSeek ทำให้ OpenAI ลดราคา 80% ฟังแรงและจำง่าย แต่สาเหตุจริงในตลาดมักซ้อนกันหลายชั้น ทั้งประสิทธิภาพชิป การปรับซอฟต์แวร์ การแคช การแข่งขันจากหลายบริษัท และแรงกดดันจากลูกค้าองค์กรที่เริ่มถามหนักขึ้นว่าเงินที่จ่ายไปให้ AI สร้างผลลัพธ์คุ้มแค่ไหน
ฝั่งคนใช้งาน สิ่งที่น่าสนใจกว่าดราม่าระหว่างบริษัทคือพฤติกรรมการใช้ AI จะเปลี่ยนเมื่อราคาต่อโทเคนลดลงแรง เดิมนักพัฒนามักออกแบบระบบให้ประหยัดคำทุกวิถีทาง เพราะการส่งข้อมูลยาวเท่ากับต้นทุนที่พุ่งขึ้น แต่เมื่อการอ่านบริบทขนาดใหญ่ถูกลง การออกแบบเอเจนต์สามารถหันไปเน้นความครบถ้วนมากขึ้น เช่น ให้ระบบอ่านเอกสารทั้งชุดก่อนตอบ ตรวจโค้ดหลายโมดูลพร้อมกัน หรือเก็บประวัติการทำงานยาวกว่าที่เคย
แต่ของถูกไม่ได้แปลว่าปลอดข้อเสีย Sparse attention มีความเสี่ยงเฉพาะตัว ถ้าระบบเลือกส่วนสำคัญพลาด ข้อมูลที่จำเป็นอาจไม่ถูกอ่านละเอียดตั้งแต่ต้น งานที่ต้องไล่ครบทุกบรรทัด เช่น รวมยอดตัวเลขจากเอกสารจำนวนมาก ตรวจข้อความกฎหมายแบบคำต่อคำ หรือเทียบโค้ดที่ต่างกันเพียงจุดเล็กๆ จึงต้องทดสอบความแม่นยำจริง ไม่ควรตัดสินจากราคาเพียงอย่างเดียว
อีกเรื่องที่คนทำระบบต้องจับตาคือราคาหน้าเว็บไม่เท่ากับต้นทุนรวม โมเดลที่ถูกกว่าแต่ต้องเรียกซ้ำหลายรอบ ออกคำตอบยาวเกินจำเป็น หรือผิดจนต้องใช้โมเดลแพงมาตรวจอีกที อาจจบด้วยบิลสูงกว่าโมเดลที่แพงตั้งแต่ต้น การวัดต้นทุนต่อหนึ่งงานที่เสร็จจริงจึงมีประโยชน์กว่าดูแค่ราคาต่อหนึ่งล้านโทเคน
การแข่งขันรอบนี้เลยไม่ได้มีแค่คำถามว่าโมเดลไหนฉลาดที่สุด แต่กลายเป็นคำถามว่าใครให้ความฉลาดที่พอใช้กับงานจริงได้ในราคาต่ำที่สุด ถ้าราคาอินพุตยังลดต่อ งานหลายประเภทที่เคยถูกมองว่าแพงเกินไปจะกลายเป็นฟีเจอร์พื้นฐานในซอฟต์แวร์ธรรมดา และฝั่งผู้ใช้จะได้อำนาจต่อรองมากขึ้นแบบเห็นชัด
ตอนนี้สิ่งที่ควรทำไม่ใช่ย้ายทุกงานไปหาโมเดลที่ถูกที่สุดทันที แต่แบ่งงานตามความเสี่ยง งานค้นหา สรุป จัดหมวด หรือประมวลผลจำนวนมากอาจเหมาะกับโมเดลราคาต่ำ ส่วนงานที่ตัวเลขต้องเป๊ะ ข้อความต้องครบ หรือความผิดพลาดมีต้นทุนสูง ควรมีชั้นตรวจสอบเพิ่ม แล้วสงครามราคาครั้งนี้จะกลายเป็นประโยชน์จริงแทนที่จะเป็นแค่ป้ายราคาที่ดูหวือหวา
https://api-docs.deepseek.com/quick_start/pricing
https://api-docs.deepseek.com/news/news260424/
https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro
https://openai.com/index/advancing-the-price-performance-frontier-with-gpt-5-6/
https://arxiv.org/abs/2502.11089
 5 โรงเรียนไทย ที่ค่าเทอมแพงที่สุด ปีละหลายแสน (ไม่รวมนานาชาติ)
 การเข้าเยี่ยมผู้ต้องขังใหม่ต้องทำอย่างไร
 ใบชมพูแม่จำเนียร สาขา 5 งวด 16 พ.ย. 69 เปิด 10 เลขขายดี จับตา 88 ยืนอันดับ 1
 เทียบ 4 สำนักหวย งวด 16 พ.ย. 69 จับตาเลข 4 ชนเลขเด่น 2-3-5-8
 AI วิเคราะห์สถิติหวยย้อนหลังแม่นกว่าสุ่มเองจริงหรือ
 กีฬาที่คนไทยเก่งที่สุด มีผลงานโดดเด่นมากที่สุดในระดับโลก
 เปิด 7 สิ่งที่แพงที่สุดในไทย ปี 2026! ตั้งแต่ที่ดินใจกลางกรุงไปจนถึงเพนต์เฮาส์ราคา 600 ล้าน
 เลขท้ายสองตัวมีโอกาสออกซ้ำงวดก่อนบ่อยแค่ไหน
 บ้านและรถของคู่สมรสหรือบุตรในคดีฟอกเงิน
 ย้อนรอย 10 เมืองหลวงเก่าแก่ที่สุดในโลก เมืองที่มีผู้คนอยู่อาศัยมานับพันปี บางแห่งมีประวัติยาวนานกว่า 5,000 ปี!
 เผย..ทำไม"ปนัดดา"จึงเป็น "นางสาวไทย" ที่ไม่ได้ไปประกวดเวทีใหญ่ในต่างแดน
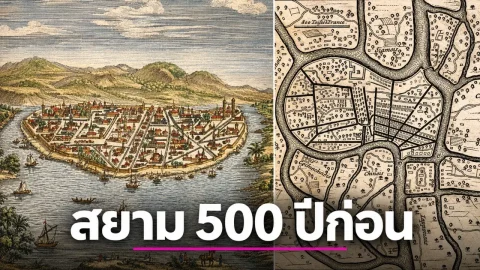 ครั้งแรกที่ต่างชาติบันทึกถึง “สยาม” เมื่อกว่า 500 ปีก่อน รู้ไหมว่าชาวโปรตุเกสมองเราอย่างไร ?
 มือถือ Gadget เทคโนโลยี
 โฟลเดอร์ซ่อนในมือถือกับความเป็นส่วนตัวก่อนส่งซ่อม
 Qwen3 8B ผ่าน Ollama: รัน AI บนคอมตัวเอง ไม่ต้องจ่ายรายเดือน ข้อมูลไม่ต้องออกนอกเครื่อง
 สร้างระบบขอเปิดกล้องวงจรปิดด้วยของฟรีล้วนๆ: Apps Script + Sheets + GitHub Pages 0 บาท ไม่ต้องเช่าเซิร์ฟเวอร์
 มือถือใหม่ พฤศจิกายน 2569 ราคาไทย รวม 6 รุ่นเด่นก่อน 11.11