ทำไมมนุษย์ถึงแพ้ AI ในเกม เมื่อหมากกระดานถูกตัดสินด้วยคณิตศาสตร์

มีช่วงหนึ่งที่คนดูหมากล้อมทั่วโลกต้องหยุดมองกระดานอยู่นานกว่าปกติ เพราะ AlphaGo ระบบปัญญาประดิษฐ์ของ DeepMind วางหมากในตำแหน่งที่ผู้เล่นมืออาชีพจำนวนมากมองว่าไม่น่าใช่ทางเลือกของมนุษย์ แต่หมากนั้นกลับกลายเป็นจุดเปลี่ยนสำคัญของเกม คำถามจึงไม่ได้มีแค่ว่าเครื่องคำนวณได้เร็วกว่าคนแค่ไหน หากอยู่ที่ว่าเครื่องมองเห็นความเป็นไปได้บนกระดานแตกต่างจากสายตามนุษย์อย่างไร หมากกระดานไม่ได้ยากเพราะกติกาซับซ้อนเสมอไป หมากล้อมมีกติกาพื้นฐานไม่กี่อย่าง วางหมากบนจุดตัด ล้อมพื้นที่ จับหมากฝ่ายตรงข้าม และจบเกมด้วยการวัดผล แต่ทันทีที่เริ่มวางหมาก จำนวนทางเลือกก็แตกออกเป็นกิ่งก้านมหาศาล กระดานขนาด 19 คูณ 19 มีจุดตัด 361 จุดในตอนเริ่มต้น และทุกหมากจะเปลี่ยนรูปแบบของกระดานทั้งแผ่น หมากรุกมีจุดเริ่มต้นแคบกว่า แต่มีการเดินต่อเนื่องและแผนระยะยาวที่ซับซ้อน ทั้งสองเกมจึงเจอปัญหาเดียวกัน ถ้าพยายามไล่ดูทุกทางตั้งแต่ต้นจนจบ จำนวนกระดานที่เป็นไปได้จะเพิ่มขึ้นเร็วจนไม่มีมนุษย์คนใดตรวจสอบได้หมด คณิตศาสตร์ของเกมประเภทนี้จึงไม่ใช่แค่การนับคะแนน แต่คือการจัดการพื้นที่ความเป็นไปได้ที่ใหญ่เกินกว่าจะมองพร้อมกันทั้งหมด มนุษย์แก้ปัญหานี้ด้วยประสบการณ์ ผู้เล่นที่เก่งจำรูปแบบได้ แยกจุดที่น่าเล่นออกจากกับดัก และตัดทางเลือกบางส่วนทิ้งตั้งแต่ต้น วิธีนี้มีประสิทธิภาพ แต่ผูกอยู่กับเวลา ความเหนื่อย ความกดดัน และอารมณ์ การยึดติดกับแผนเดิมหรือความเสียดายหมากที่เดินไปแล้วก็ทำให้การประเมินเปลี่ยนได้
จุดแข็งสำคัญไม่ใช่การลองทุกทาง แต่คือการรู้ว่าจะไม่ต้องเสียเวลาไปกับทางไหน
โครงสร้างของ AlphaGo แบ่งหน้าที่กันหลายชั้น ชั้นแรกคือ policy network เครือข่ายที่ประเมินว่าหมากใดมีแนวโน้มเหมาะสม ช่วยคัดทางเลือกที่น่าสนใจออกจากทางเลือกทั้งหมด ชั้นถัดมาคือ value network ซึ่งประเมินภาพรวมของตำแหน่งว่า หากเดินมาถึงจุดนี้แล้ว ฝ่ายใดมีโอกาสชนะมากกว่า การประเมินนี้ไม่ใช่คำทำนายที่แน่นอน แต่ช่วยให้ระบบไม่ต้องตัดสินจากการสุ่ม จากนั้นจึงใช้ Monte Carlo Tree Search ระบบสร้างต้นไม้ของทางเลือก เลือกสำรวจบางกิ่ง ขยายกิ่งที่ดูมีศักยภาพ ประเมินผลลัพธ์ แล้วส่งข้อมูลย้อนกลับไปปรับน้ำหนักของแต่ละทาง เมื่อทำซ้ำจำนวนมาก ทางเลือกที่ดูดีจะได้รับการตรวจสอบละเอียดขึ้น ส่วนทางเลือกที่เสียเปรียบจะถูกลดความสำคัญลง AI จึงไม่ได้คำนวณทุกความเป็นไปได้ แต่ทุ่มกำลังไปยังจุดที่มีผลต่อเกมจริง นี่คือเหตุผลที่ AI บางครั้งเดินหมากซึ่งคนดูรู้สึกว่าแปลก ผู้เล่นมนุษย์มักเชื่อรูปแบบที่เคยเห็นหรือดูสมเหตุผลเมื่อมองระยะสั้น ส่วนระบบอาจพบว่าหมากที่เสียพื้นที่เล็กน้อยในตอนนี้ ทำให้โอกาสชนะโดยรวมสูงขึ้นในอีกหลายสิบจังหวะข้างหน้า มนุษย์เห็นการเสียสละหนึ่งจุด แต่ AI ประเมินความสัมพันธ์ของทั้งกระดานพร้อมกัน อีกส่วนที่สำคัญคือการฝึกด้วยการเล่นกับตัวเอง ระบบเล่นเกมซ้ำจำนวนมหาศาล เก็บผลแพ้ชนะ แล้วปรับแบบจำลองให้เลือกทางที่มีโอกาสดีกว่าเดิม การแพ้หนึ่งเกมไม่ใช่ความอับอาย แต่เป็นข้อมูลสำหรับปรับพารามิเตอร์ การเล่นซ้ำจึงไม่ติดข้อจำกัดแบบมนุษย์ที่ต้องใช้เวลา ต้องหาคู่แข่ง และมีจำนวนชั่วโมงต่อวันจำกัด AlphaGo รุ่นแรกเริ่มจากการเรียนรู้เกมของผู้เล่นฝีมือดี แล้วใช้การเล่นกับตัวเองเพิ่มความสามารถ ก่อนชนะ Fan Hui แชมป์ยุโรปห้าเกมต่อศูนย์ในปี 2015 และเอาชนะ Lee Sedol แชมป์ระดับเก้าดั้งในปี 2016 ด้วยคะแนนสี่เกมต่อหนึ่ง ต่อมา AlphaGo Zero แสดงให้เห็นว่าระบบเรียนรู้หมากล้อมจากกติกาและการเล่นกับตัวเองได้ โดยไม่ต้องเริ่มจากฐานข้อมูลเกมมนุษย์แบบเดิม ส่วน AlphaZero ขยายแนวคิดนี้ไปยังหมากล้อม หมากรุก และโชงิ เรื่องนี้ทำให้เห็นความแตกต่างระหว่างคำว่า “คิด” ของมนุษย์กับกระบวนการคำนวณของ AI มนุษย์อาจอธิบายว่าหมากหนึ่งสวย กล้าหาญ หรือมีจิตวิทยา ขณะที่ระบบรับสถานะของกระดาน ประเมินทางเลือก และเลือกการกระทำให้สอดคล้องกับเป้าหมายที่ตั้งไว้ ผลลัพธ์อาจดูเหมือนมีความเข้าใจ แต่ไม่ได้หมายความว่าระบบกำลังคิดด้วยประสบการณ์แบบเดียวกับมนุษย์ การแพ้ AI ในเกมจึงไม่ได้แปลว่ามนุษย์ด้อยกว่าในทุกเรื่อง สนามแข่งขันถูกกำหนดให้กติกาชัด เป้าหมายชัด สถานะของเกมมองเห็นได้ และผลลัพธ์ตรวจสอบได้ทันที ถ้าเปลี่ยนเป็นงานที่ต้องตีความความรู้สึก เจรจาในสถานการณ์คลุมเครือ รับผิดชอบต่อความสำคัญหลายด้าน หรือรับมือกับกติกาที่เปลี่ยนตลอดเวลา ความได้เปรียบของ AI ก็ไม่เหมือนเดิม แม้แต่ในเกม ระบบก็ไม่ได้ไร้จุดอ่อน การประเมินขึ้นอยู่กับกติกา ข้อมูลฝึก วิธีให้คะแนน และจำนวนการค้นหาที่ใช้ ถ้าสภาพแวดล้อมผิดจากที่ระบบคุ้นเคย หรือมีตำแหน่งที่หลอกกระบวนการประเมินได้ ผลลัพธ์ก็อาจไม่น่าเชื่อถือ การชนะของ AI จึงเป็นความสามารถสูงภายใต้เงื่อนไขหนึ่ง ไม่ใช่หลักฐานว่าระบบเข้าใจโลกทั้งหมด สำหรับผู้เล่นทั่วไป ประโยชน์ของ AI ไม่ได้อยู่ที่การเปิดดูว่าหมากไหนดีที่สุดแล้วทำตามทันที แต่อยู่ที่การใช้เป็นกระจกสะท้อนวิธีคิด ลองดูว่าทางเลือกที่ถูกมองข้ามมีอะไรซ่อนอยู่ ทำไมการป้องกันที่ดูปลอดภัยจึงเสียเปรียบ และเหตุใดหมากที่ดูประหลาดจึงได้เปรียบในภาพรวม การเรียนรู้แบบนี้ช่วยขยายคลังรูปแบบในสมอง โดยยังรักษาความเข้าใจว่าคะแนนบนหน้าจอไม่ใช่คำตอบของทุกสถานการณ์ สิ่งที่เกมกระดานเปิดเผยจึงไม่ใช่แค่เรื่องเครื่องจักรชนะคน แต่เป็นเรื่องของข้อจำกัดในการมองเห็นทางเลือก มนุษย์ใช้ความหมายและประสบการณ์ ส่วน AI ใช้การทดลองซ้ำ การคาดการณ์ และการตัดสิ่งที่ไม่จำเป็นออกไป เมื่อสองความสามารถนี้ถูกนำมาใช้ร่วมกัน เกมก็กลายเป็นห้องทดลองที่ทำให้เห็นว่า การตัดสินใจหนึ่งครั้งเกิดจากข้อมูล รูปแบบ และการประเมินอนาคตอย่างไร
 สนามบินที่ตั้งอยู่ห่างไกลจากตัวเมืองมากที่สุดในประเทศไทย
 พริกขี้หนูที่กินบ่อยเกี่ยวข้องกับอายุขัยหรือไม่
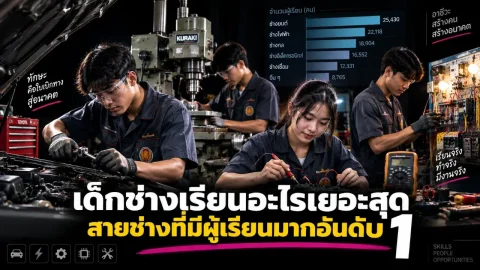 เด็กเทคนิคเรียนสายไหนมากที่สุด เปิดข้อมูลอาชีวะ สายช่างที่มีผู้เรียนมากอันดับ 1
 น้ำเซเลอรี่คั้นสดช่วยลดความดันได้จริงแค่ไหน
 หมายเลขบนหมวกตำรวจมีไว้ทำไม ตัวเลขที่เห็นทุกวัน แท้จริงใช้ระบุตัวเจ้าหน้าที่
 รู้หรือไม่? ปลาในประเทศไทยบางชนิดไม่ได้จับหรือซื้อขายกันได้อย่างที่คิด 🐟
 อำเภอที่ขอแยกตัวเป็นจังหวัด อำเภอล่าสุดของประเทศไทย
 ลูกเกดช่วยป้องกันฟันผุได้จริงหรือไม่
 ล้อมรีสอร์ตล็อกตัว “เน็ต” เจอยาบ้า 213 เม็ด พร้อมถุงแบ่ง 117 ใบ
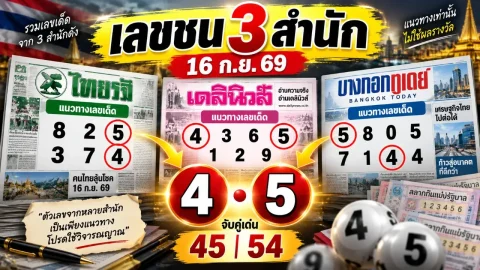 เลขชน 3 สำนัก 16 ก.ย. 69 ไทยรัฐ-เดลินิวส์-บางกอกทูเดย์ เลข 4-5 โผล่ครบ
 “อ่าวนางกวาดต่อเนื่อง! รวบผู้ต้องหาพร้อมยาบ้า 9 เม็ด”
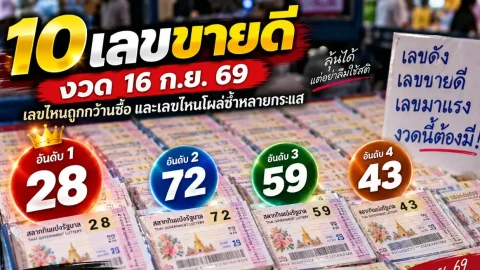 เปิด 10 เลขขายดี งวด 16 ก.ย. 69 เลขไหนถูกกว้านซื้อ และเลขไหนโผล่ซ้ำหลายกระแสสนามบินที่ตั้งอยู่ห่างไกลจากตัวเมืองมากที่สุดในประเทศไทย
 เปิดรายได้ครู ตชด. พื้นที่ห่างไกล เงินเดือนเท่าไร ได้เงินเพิ่มอะไรบ้าง?
 แกนสับปะรดมีบรอมีเลนมากกว่าส่วนอื่นจริงไหม
 ลูกจันทน์เทศกินมากแค่ไหนถึงเสี่ยงพิษ
 เมล็ดมะละกอใช้แทนพริกไทยและถ่ายพยาธิได้จริงไหม
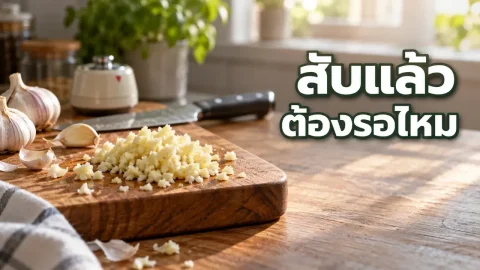 สับกระเทียมแล้วควรพักก่อนผัดหรือไม่
 สาระ เกร็ดน่ารู้
 เหตุด่วน...เหตุร้าย หรือเพราะแค่อยากรู้?" ถอดรหัสจิตวิทยา ทำไมมนุษย์ถึงชอบหยุดดู "เรื่องดราม่า" ทั้งที่ไม่ได้เกี่ยวอะไรกับตัวเองทำไมคนที่ชอบทำตัวเป็นน้ำไม่เต็มแก้ว ลึกๆ แล้วอาจเป็นคนที่กลัวการโดนจับได้ว่าตัวเองไม่ได้รู้จริง?ทำไมการโดนด่าบนโลกออนไลน์ ถึงสร้างบาดแผลทางใจได้แรงพอๆ กับการโดนทำร้ายร่างกายจริงๆ?📷 5 ภาพถ่ายโบราณแบบออริจินัล ที่กลายเป็นของสะสมทรงคุณค่าราคาแพง