Qwen3 8B ผ่าน Ollama: รัน AI บนคอมตัวเอง ไม่ต้องจ่ายรายเดือน ข้อมูลไม่ต้องออกนอกเครื่อง
วันที่ 2 พฤศจิกายน 2569 ผมเลือก Qwen3 8B เป็นโมเดล AI หลักบนคอมตัวเอง ใช้ผ่านโปรแกรม Ollama บนคอมเครื่องเดิมที่ใช้ทำงานทุกวัน RAM 16GB กับการ์ดจอ NVIDIA GeForce GTX ไม่ได้ซื้อเครื่องใหม่ ไม่ได้สมัครแพ็กเกจรายเดือนเพิ่ม เหตุผลมีสองข้อ ข้อแรกคือข้อมูลไม่ต้องออกนอกเครื่อง ข้อสองคือใช้เมื่อไรก็ได้โดยไม่ต้องนับเครดิต บทนี้เล่าจากที่ผมใช้จริง ว่าโมเดลตัวนี้คืออะไร เริ่มใช้ยังไง และใช้มันทำอะไรบ้าง รวมถึงอะไรที่ไม่ควรให้มันทำ
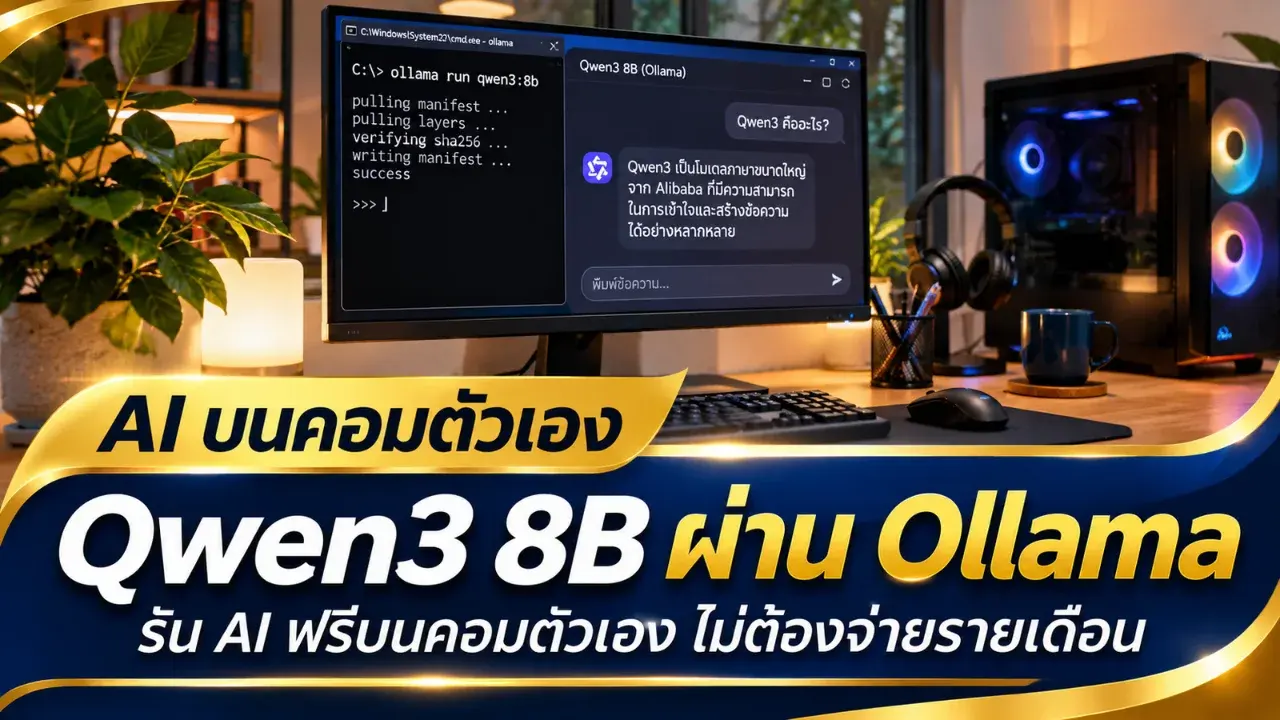
คำว่า "รันบนคอมตัวเอง" หมายความตรงตัว โมเดลเป็นไฟล์ที่โหลดเก็บไว้ในดิสก์ของเรา เปิดโปรแกรมแล้วคุยกับมันได้เลยโดยไม่ต้องผ่านเซิร์ฟเวอร์ของใคร ไม่ต้องสมัครบัญชี ไม่ต้องผูกบัตรเครดิต และหลังโหลดโมเดลแล้วจะปิดเน็ตก็ยังใช้งานได้ ต่างจาก AI บนคลาวด์ที่ทุกข้อความต้องส่งออกไปประมวลผลข้างนอกและคิดเงินตามการใช้งาน
Qwen3 8B คืออะไร 🤖
Qwen3 เป็นโมเดลภาษาขนาดใหญ่ของทีม Qwen จาก Alibaba Cloud เปิดตัวเมื่อ 29 เมษายน 2025 เปิดน้ำหนักโมเดลให้ดาวน์โหลดไปรันเองได้ภายใต้ไลเซนส์ Apache 2.0 ซึ่งใช้เชิงพาณิชย์ได้ ตระกูลนี้มีหลายขนาดตั้งแต่ 0.6B ไปจนถึง 235B ส่วน 8B คือขนาดกลางที่คอมบ้านทั่วไปรันไหว ตัวเลข 8B หมายถึงพารามิเตอร์ประมาณ 8.2 พันล้านตัว โมเดลรองรับมากกว่า 100 ภาษา และจำบริบทได้ 32,768 โทเคน อีกจุดเด่นคือสลับโหมดได้ในตัวเดียว โหมดคิดสำหรับโจทย์ที่ต้องใช้เหตุผล กับโหมดตอบเร็วสำหรับคุยทั่วไป ตัว 8B ที่ผมใช้รับเฉพาะข้อความ ไม่ได้อ่านรูป ถ้าอยากให้ AI อ่านภาพต้องใช้รุ่น VL แยกต่างหาก โหมดคิดเปิดเป็นค่าเริ่มต้น สั่งปิดได้ด้วยคำสั่ง /no_think หรือเปิดด้วย /think ตามแต่ละรอบคุย ส่วนรุ่นปรับปรุง Qwen3-2507 ที่ออกมาช่วงกลางปี 2025 ปรับเฉพาะขนาด 4B, 30B และ 235B ตัว 8B ยังใช้น้ำหนักโมเดลชุดเดิมจากเดือนเมษายน 2025
Ollama คืออะไร 💻
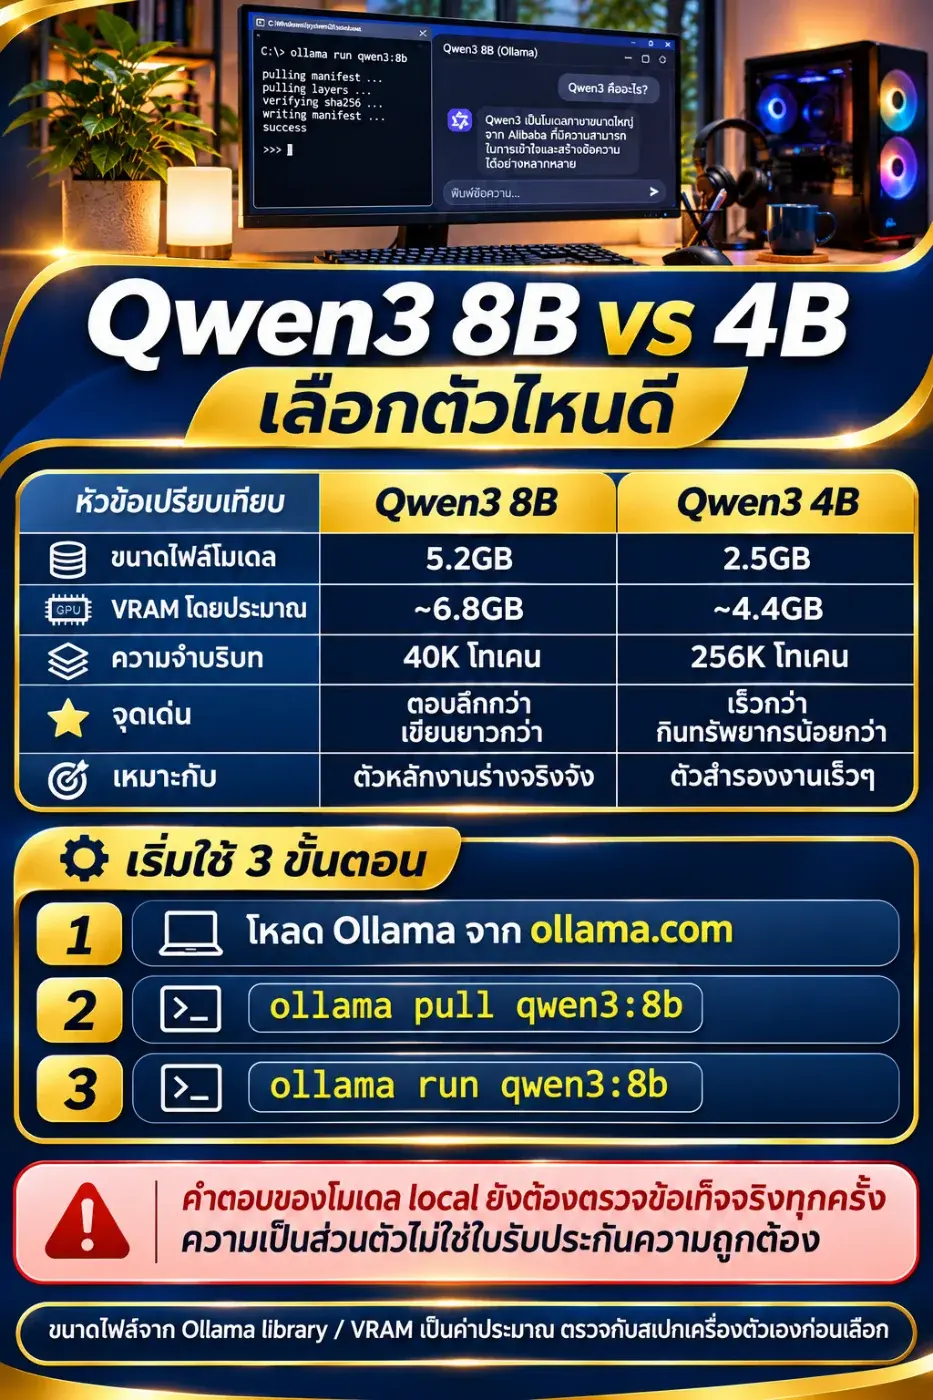
Ollama เป็นโปรแกรมฟรีแบบ open-source ที่ทำหน้าที่โหลด จัดการ และรันโมเดลบนคอมตัวเอง รองรับ Windows, macOS และ Linux ติดตั้งจาก ollama.com โหลดตัวติดตั้งมารันตามปกติ ส่วน Linux ใช้สคริปต์ทางการบรรทัดเดียว หลังติดตั้งแล้วโหลดโมเดลด้วยคำสั่ง ollama pull qwen3:8b แล้วรันด้วย ollama run qwen3:8b โมเดลจะโหลดเข้าแรมหรือการ์ดจอแล้วเปิดให้คุยผ่านหน้าต่างคำสั่งได้ทันที จุดที่สำคัญที่สุดคือหลังโหลดโมเดลแล้วไม่ต้องใช้อินเทอร์เน็ตอีก ข้อความที่พิมพ์คุยกับโมเดลไม่ถูกส่งออกไปไหน ถ้าเครื่องไม่มีการ์ดจอที่รองรับ Ollama จะรันบน CPU แทน แค่ตอบช้าลง และ Ollama ยังเปิด API ภายในเครื่องให้โปรแกรมอื่นเรียกใช้โมเดลได้โดยไม่ต้องผ่านคลาวด์
8B กับ 4B เลือกยังไง ⚖️
ถ้าคอมแรงพอ 8B คือตัวหลัก ไฟล์โมเดลประมาณ 5.2GB ใช้ VRAM ราว 6.8GB ที่บริบท 8K ตอบได้ลึกกว่า เขียนได้ยาวกว่า ส่วน 4B ไฟล์ประมาณ 2.5GB ใช้ VRAM ราว 4.4GB ตอบเร็วกว่าและกินทรัพยากรน้อยกว่า ผมใช้ 4B เป็นตัวสำรองเวลาอยากได้คำตอบเร็วๆ หรืองานที่ไม่ซับซ้อน อีกจุดที่ต่างกันคือความจำบริบท บน Ollama ตัว 4B จำได้ 256K โทเคน ส่วน 8B จำได้ 40K โทเคน งานที่ต้องป้อนเอกสารยาวๆ 4B อาจเหมาะกว่าแม้จะตัวเล็กกว่า แต่ข้อควรรู้คือบนการ์ดจอ GTX รุ่นเก่าที่ VRAM น้อย 8B อาจตอบช้ากว่าที่คิด หรือต้องพึ่ง CPU ช่วย รันได้ไม่เท่ากับรันลื่น ถ้าเครื่องตอบช้าจนหงุดหงิด ลดไปใช้ 4B ก่อนดีกว่าฝืนใช้ 8B
ผมใช้มันทำอะไร และอะไรที่ไม่ให้มันทำ ✍️
งานหลักของผมมีสามอย่าง ร่างบทความ สรุปเนื้อหา และคิดมุมหรือโครงเรื่อง ทุกอย่างที่โมเดลร่างออกมาต้องผ่านการตรวจข้อเท็จจริงและ gates เต็มรูปแบบก่อนโพสต์เสมอ โมเดล local ไม่ได้เข้ามาแทนขั้นตอนนั้น แค่เข้ามาแทนหน้ากระดาษเปล่าตอนเริ่มต้น อีกเรื่องที่ผมทำเสมอคือร่างยาวต้องแบ่งเป็นช่วงสั้นๆ ป้อนทีละช่วง ไม่ป้อนทั้งก้อน เพราะยิ่งป้อนยาว โมเดลยิ่งหลุดประเด็น และตรวจแก้ยาก วิธีที่ผมใช้คือให้โมเดลช่วยวางโครงก่อน แล้วค่อยร่างทีละส่วน ตรวจทีละส่วน แทนที่จะสั่งให้เขียนทั้งบทในครั้งเดียว มุมกับพาดหัวสุดท้ายผมเป็นคนเลือกเองเสมอ โมเดลแค่เสนอตัวเลือกมาให้เทียบ บทความที่ลงชื่อผมต้องผ่านมือผมทุกบรรทัด ไม่ใช่กดรับร่างที่โมเดลเขียนมาทั้งดุ้น สิ่งที่ต้องจำไว้คือคำตอบของโมเดล local ยังต้องตรวจเหมือน AI ตัวอื่น มันแต่งตัวเลขและอ้างอิงได้เหมือนกัน แค่ไม่ต้องส่งข้อมูลออกนอกเครื่อง ความเป็นส่วนตัวไม่ใช่ใบรับประกันความถูกต้อง
และมันทำอะไรไม่ได้บ้าง ถามข่าววันนี้ไม่ได้เพราะไม่มีอินเทอร์เน็ตในตัว ความรู้หยุดอยู่ที่ช่วงที่ฝึกโมเดล ถามเรื่องที่เกิดหลังวันนั้นมันจะตอบจากความจำเก่าหรือแต่งขึ้นมา งานที่ต้องใช้ข้อมูลสดจึงยังต้องค้นจากแหล่งทางการเอง
สรุป ✅
ถ้ามีคอม RAM 16GB กับการ์ดจอแยกอยู่แล้ว อยากได้ AI ช่วยร่างงานโดยไม่ต้องจ่ายรายเดือน และไม่อยากส่งข้อมูลออกนอกเครื่อง Qwen3 8B ผ่าน Ollama คือจุดเริ่มที่สมเหตุสมผลที่สุดตอนนี้ แต่ถ้าอยากได้คำตอบเร็วบนเครื่องสเปกต่ำ เริ่มที่ 4B ก่อนก็ได้ ส่วนใครไม่มีคอมแรงๆ หรืออยากได้ข้อมูลสดตลอดเวลา ใช้ AI บนคลาวด์ต่อไปเถอะ ไม่ต้องฝืนรัน local ถ้าแค่อยากลองคุยกับ AI เป็นครั้งคราว ไม่ได้ใช้ทุกวัน ก็ไม่ต้องเสียเวลาติดตั้ง ใช้ของฟรีบนเว็บก็พอ และอย่าลืมว่า "ฟรี" ในที่นี้หมายถึงไม่จ่ายค่าโมเดลกับค่ารายเดือน แต่ค่าไฟตอนรันกับเวลาที่เสียไปกับการเซ็ตอัปและดูแลเองก็เป็นต้นทุนเหมือนกัน อีกอย่างที่ควรทราบคือ Qwen3 ไม่ใช่รุ่นใหม่สุดแล้ว มีรุ่นถัดไปออกมาตามมา แต่สำหรับขนาด 8B ที่คอมบ้านรันไหว มันยังเป็นตัวเลือกที่ลงตัวอยู่
สรุปสั้นๆ: AI บนคอมตัวเองทำได้จริง ไม่ต้องจ่ายรายเดือน แค่ต้องใช้มันให้ถูกที่ ร่างได้ แต่ข้อเท็จจริงต้องตรวจเองทุกครั้ง
เขียนโดย พีรพัฒน์ พีพี
 เปิด 5 ประเทศในโลก ที่ไม่เคยตกเป็นเมืองขึ้นของประเทศอื่น
 ตำนานอสูรกายแวมไพร์แห่งเบลดเดนโบโร (The Beast of Bladenboro): เมื่อความหวาดผวาเข้าครอบงำเมืองเล็ก ๆ ในปี 1954
 แบรนด์รถมอเตอร์ไซค์สัญชาติไทย ที่ประสบความสำเร็จมากที่สุดแบรนด์หนึ่งของประเทศ
 ความลับของ "รอยบากหยักที่สายรัดเคเบิลไทร์ (Cable Tie)" มีไว้ทำไม?
 10 ชื่อหญิงไทย ฮิตตั้งแต่โบราณจนถึงปัจจุบัน
 ทำไม "รูระบายความร้อนที่พื้นรองเท้าคัทชูหรือรองเท้าทำงานบางรุ่น" ถึงต้องทำไว้ที่พื้นรองเท้า?
 เบื้องหลัง "ลายตารางข้าวหลามตัดหรือร่องนูนที่ด้ามจับไขควงพลาสติก" มีไว้ทำไม?
 แนวทางเลขปิงปองเพชรกล้า ครั้งที่ 177 ลุ้นสลากสัญจรงวด 16 พฤศจิกายน 2569 ถอดสถิติเด่นน่าจับตา
 ประเทศยักษ์ใหญ่อันดับ 1 ของโลก ที่มีปริมาณการส่งออกข้าวมากที่สุด
 7 จังหวัดในไทยที่มีพื้นที่ป่าไม้มากที่สุด เปิดอาณาจักรสีเขียวผืนใหญ่ที่ยังคงความอุดมสมบูรณ์
 ทำไม "ลวดเย็บกระดาษ (Max)" ถึงต้องทำเป็นเส้นยาวต่อกันและหักงอเป็นมุมฉากเมื่อถูกกดลงไป?
 5 โรงเรียนไทย ที่ค่าเทอมแพงที่สุด ปีละหลายแสน (ไม่รวมนานาชาติ)
 มือถือ Gadget เทคโนโลยี